Dlaczego sztuczna inteligencja nie widzi Twojej strony? 7 problemów, o których warto wiedzieć
Wtorek, 27 października 2026
Twoja strona internetowa może zajmować wysokie pozycje w Google, regularnie pozyskiwać klientów i działać bez zarzutu w przeglądarce, a mimo to napotykać poważne ograniczenia w dostępie dla systemów sztucznej inteligencji. Wraz z rosnącą popularnością ChatGPT, Gemini, Claude i Perplexity przedsiębiorcy coraz częściej zastanawiają się, czy ich witryny są odpowiednio przygotowane do nowych sposobów wyszukiwania informacji. Problem polega na tym, że tradycyjna optymalizacja SEO nie zawsze obejmuje kontrolę dostępu robotów wykorzystywanych przez dostawców rozwiązań AI. Błędna konfiguracja pliku robots.txt, zabezpieczenia serwera, nieprawidłowe odpowiedzi HTTP czy treści generowane wyłącznie przez JavaScript mogą utrudniać automatyczne odczytywanie informacji o firmie. Co istotne, właściciel witryny często nie zdaje sobie z tego sprawy, ponieważ z jego perspektywy wszystko działa poprawnie. Warto więc poznać siedem problemów technicznych, które mogą ograniczać dostępność strony dla asystentów AI, oraz sposoby ich diagnozowania.
Pierwszym istotnym zagadnieniem jest różnica między robotami wyszukiwarek internetowych a systemami wykorzystywanymi przez dostawców sztucznej inteligencji. Googlebot odpowiada za odkrywanie i pobieranie zasobów wykorzystywanych w wyszukiwarce Google, natomiast OpenAI korzysta z kilku odrębnych mechanizmów o różnych zastosowaniach. OAI-SearchBot służy do odkrywania treści na potrzeby wyszukiwania w ChatGPT, GPTBot może pobierać informacje wykorzystywane przy rozwijaniu modeli, a ChatGPT-User jest związany z określonymi działaniami inicjowanymi przez użytkowników. Oznacza to, że udostępnienie strony jednemu robotowi nie jest równoznaczne z zapewnieniem dostępu wszystkim pozostałym. Podobne rozróżnienia mogą występować w przypadku innych dostawców technologii AI. Właściciel strony, który kontroluje wyłącznie możliwość indeksowania przez Google, może więc przeoczyć ograniczenia mające znaczenie dla nowych kanałów pozyskiwania informacji i potencjalnych klientów.
Ważne jest również odróżnienie technicznej dostępności od rzeczywistej widoczności w odpowiedziach generowanych przez sztuczną inteligencję. Nawet jeśli robot może prawidłowo pobrać dokument HTML, nie oznacza to automatycznie, że ChatGPT będzie polecał daną firmę lub cytował jej ofertę. O wyborze źródeł mogą decydować między innymi charakter zapytania, dostępność aktualnych informacji, jakość treści i sposób działania konkretnego systemu. Dostępność techniczna pozostaje jednak podstawowym obszarem, który przedsiębiorca może samodzielnie kontrolować i optymalizować. W praktyce warto więc rozpocząć od sprawdzenia, czy serwer odpowiada prawidłowo na żądania robotów, czy zasady dostępu zostały świadomie skonfigurowane oraz czy najważniejsze informacje o produktach i usługach są możliwe do odczytania. Dopiero po wyeliminowaniu takich barier można rozsądnie rozwijać działania związane z widocznością marki w wyszukiwarkach i odpowiedziach AI.
Problem 1: Nieprawidłowe reguły w pliku robots.txt. Plik robots.txt informuje roboty internetowe, które zasoby witryny mogą być pobierane zgodnie z zasadami ustalonymi przez administratora. Część właścicieli stron nieświadomie blokuje dostęp odpowiednim botom, korzystając z gotowych konfiguracji zabezpieczeń lub ustawień wprowadzonych wcześniej przez wykonawcę witryny. Szczególnie problematyczne bywają szerokie reguły Disallow, które obejmują również podstrony ofertowe, kategorie produktów lub artykuły eksperckie. Należy przy tym pamiętać, że zablokowanie GPTBot nie jest tym samym co zablokowanie OAI-SearchBot. Pierwszy dotyczy wykorzystania treści przy rozwijaniu modeli OpenAI, natomiast drugi jest związany z funkcjami wyszukiwania ChatGPT. Firma może zatem ograniczać określone zastosowania swoich materiałów, jednocześnie umożliwiając ich odkrywanie przez system wyszukiwania. Najważniejsze jest świadome zarządzanie dostępem i sprawdzanie reguł dla konkretnych identyfikatorów robotów, zamiast stosowania przypadkowych blokad.
Problem 2: Blokady WAF, Cloudflare i systemów antybotowych. Drugą częstą przyczyną problemów są zabezpieczenia serwera, które mają chronić witrynę przed niepożądanym ruchem. Systemy takie jak Cloudflare WAF mogą analizować żądania HTTP, identyfikować podejrzane zachowania i ograniczać dostęp wybranym klientom. Jeżeli konfiguracja jest zbyt restrykcyjna, prawidłowe żądania botów mogą kończyć się odpowiedzią 403 Forbidden, dodatkowym mechanizmem weryfikacyjnym albo wyświetleniem strony zabezpieczającej zamiast właściwej zawartości. Problem nie musi występować u zwykłych użytkowników, dlatego trudno wykryć go podczas standardowego przeglądania witryny. Co więcej, samo podstawienie nazwy bota w nagłówku User-Agent nie dowodzi, że żądanie pochodzi od jego rzeczywistego operatora. Z tego powodu wyniki testów symulacyjnych warto uzupełniać analizą logów serwera i weryfikacją oficjalnych zakresów adresów IP robotów. Takie podejście pozwala rozróżnić potencjalną blokadę od problemu występującego wyłącznie w określonym środowisku testowym.
Wykrycie problemów z dostępnością dla robotów AI wymaga szerszego spojrzenia niż zwykły test działania witryny w przeglądarce. Należy sprawdzić reguły robots.txt, odpowiedzi HTTP, obecność zabezpieczeń wymagających dodatkowej weryfikacji oraz zawartość dokumentu otrzymywanego przez klienta automatycznego. Ważne jest również rozróżnienie grup botów odpowiedzialnych za wyszukiwanie informacji, pobieranie stron na żądanie użytkownika oraz gromadzenie treści na potrzeby rozwijania modeli. Samo stwierdzenie, że domena nie blokuje jednego popularnego robota, nie wystarcza do kompleksowej oceny jej technicznej dostępności. Dodatkowo warto ustalić, czy treści przekazywane użytkownikowi i klientowi identyfikującemu się jako bot są spójne oraz czy strona nie wymaga wykonania dużej liczby skryptów, zanim pojawią się podstawowe informacje o firmie. Tego rodzaju diagnostyka pozwala wskazać konkretne ograniczenia, które następnie można przekazać administratorowi lub programiście odpowiedzialnemu za utrzymanie witryny.
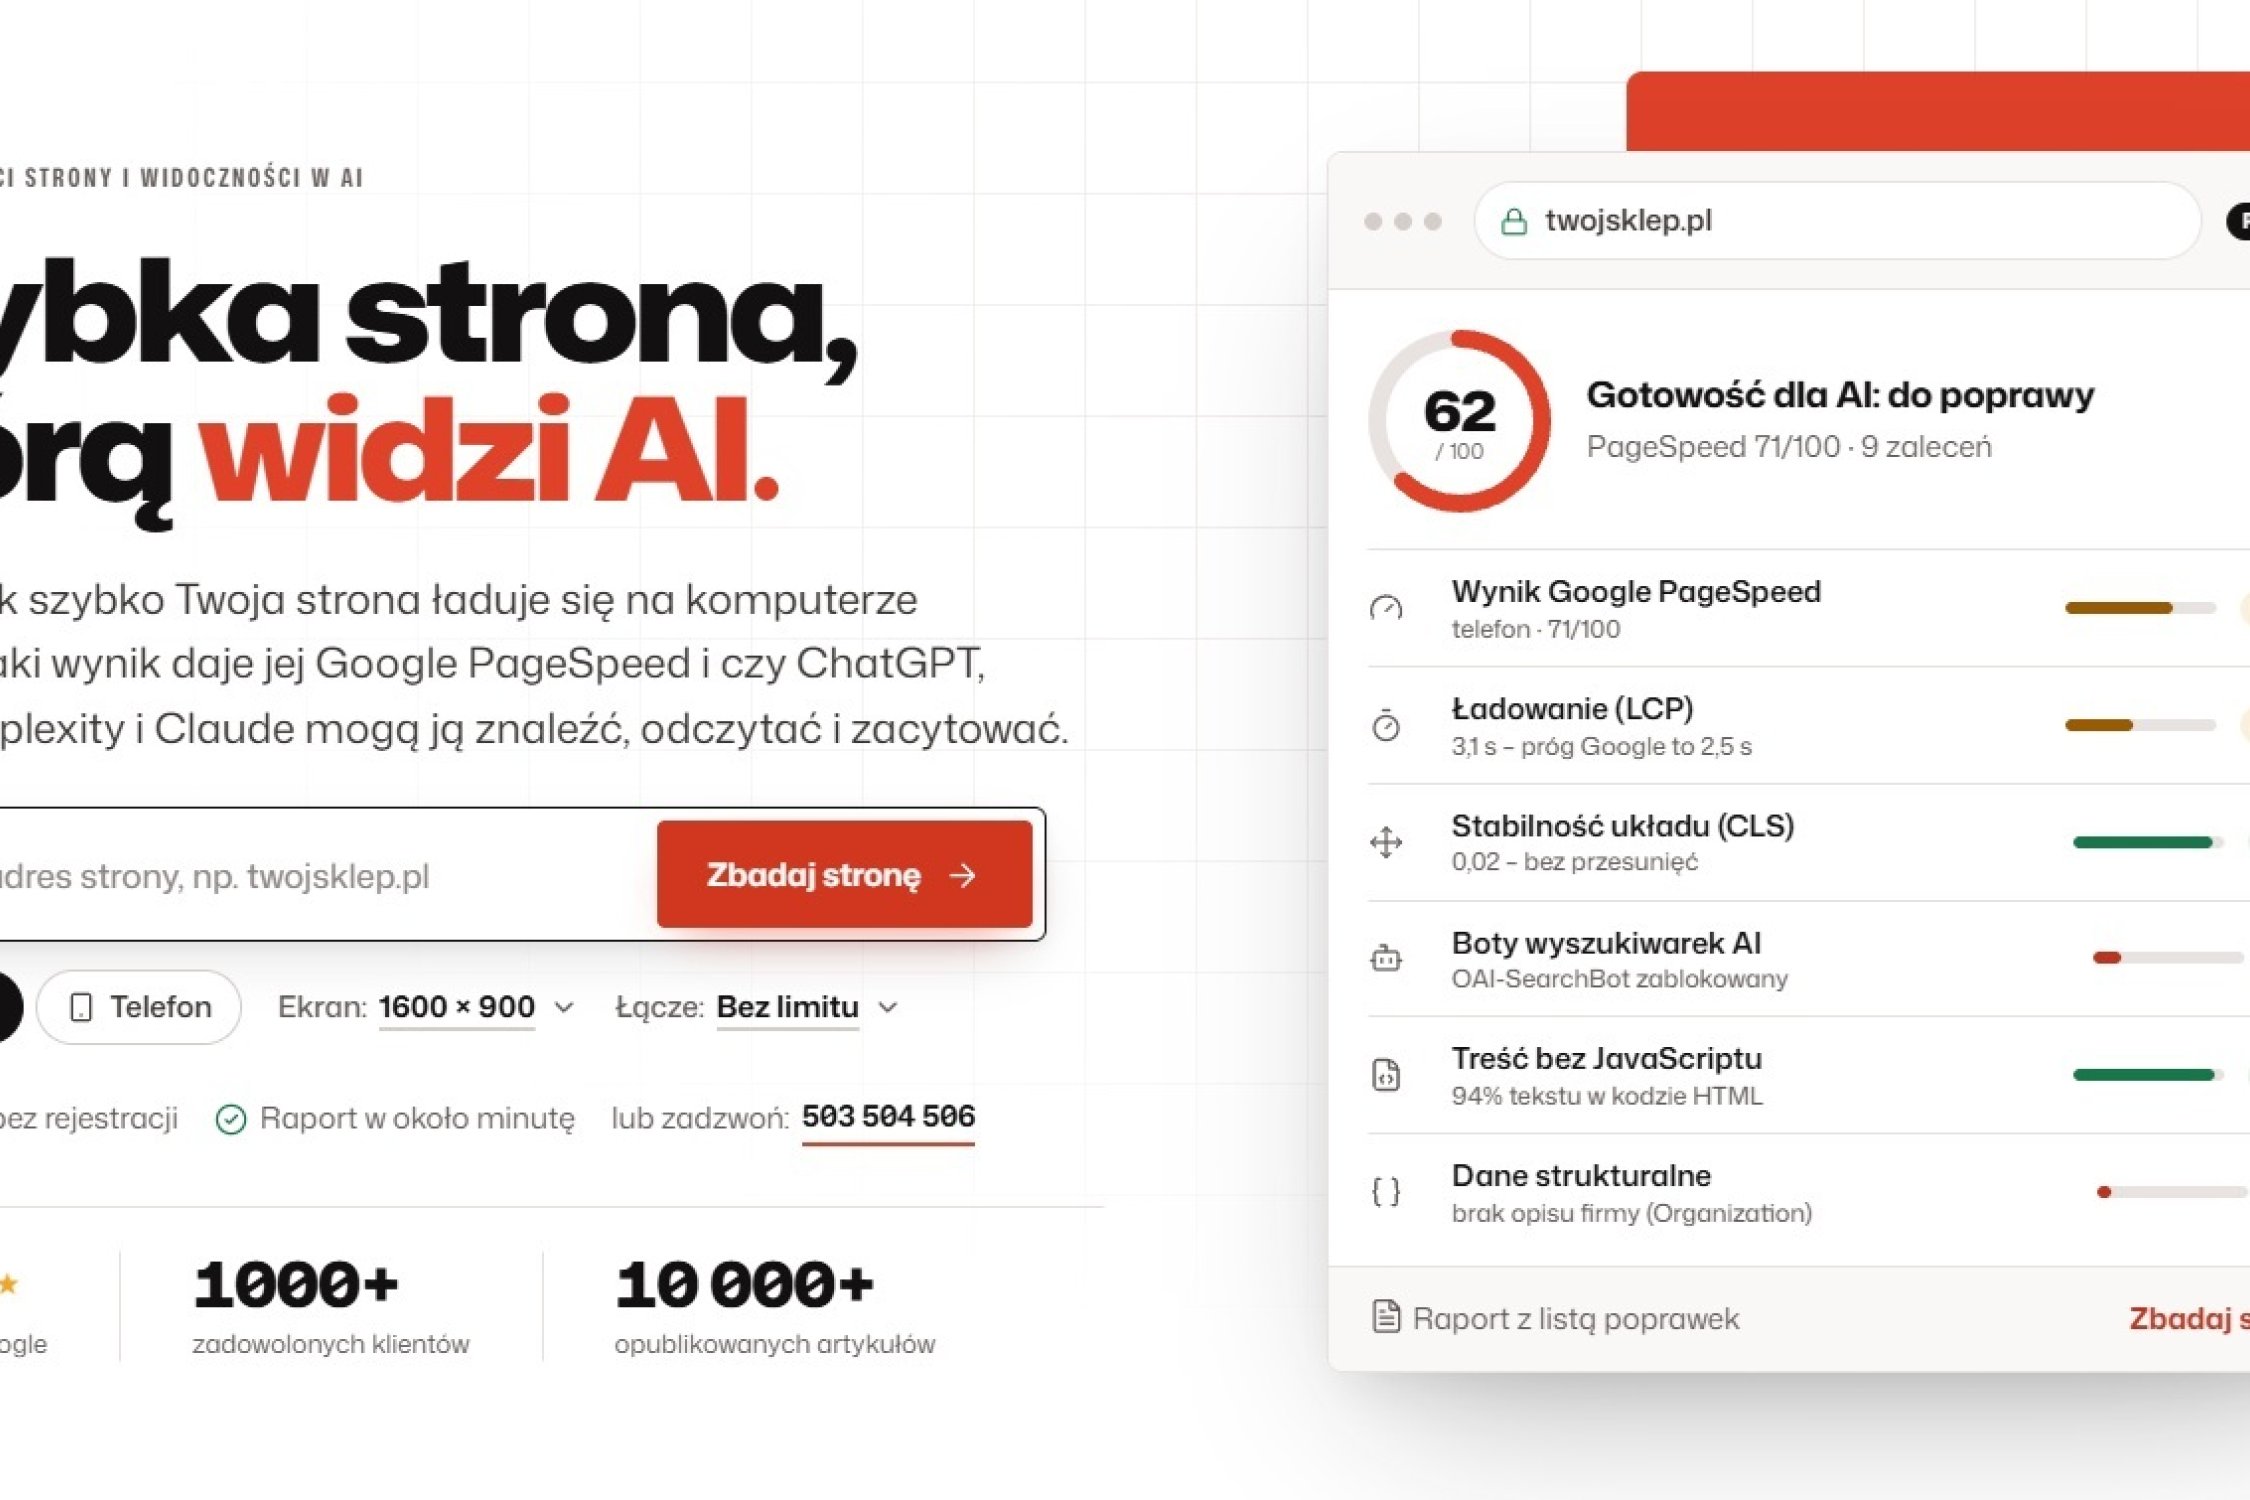
Pomocnym rozwiązaniem jest audyt gotowości strony dla AI opracowany przez agencję marketingową Brand.ceo. Bezpłatne narzędzie umożliwia analizę wybranego adresu internetowego i przedstawia wynik technicznej gotowości w skali od 0 do 100. System sprawdza reguły dostępu dla 26 botów AI, wykonuje zapytania identyfikujące się jako 14 różnych robotów oraz porównuje otrzymywane odpowiedzi z zachowaniem strony wobec standardowego klienta. Analizowane są także zawartość HTML przed wykonaniem JavaScriptu, dane strukturalne, nagłówki, metadane i dodatkowe sygnały techniczne. Co ważne, raport nie ogranicza się do wskazania samej oceny, lecz zawiera opisy wykrytych problemów oraz sugerowane sposoby ich rozwiązania. Równolegle użytkownik otrzymuje możliwość sprawdzenia wydajności strony w Chrome i oficjalnego wyniku Google PageSpeed. Takie połączenie pozwala ocenić dwa istotne obszary funkcjonowania witryny bez konieczności korzystania z kilku oddzielnych narzędzi. Wynik należy traktować jako diagnostykę techniczną, a nie potwierdzenie faktycznej obecności strony w odpowiedziach konkretnych modeli AI.
Problem 3: Najważniejsze treści są dostępne dopiero po wykonaniu JavaScriptu. Współczesne witryny coraz częściej wykorzystują rozbudowane frameworki, które generują część zawartości dopiero po uruchomieniu skryptów w przeglądarce. Użytkownik może widzieć kompletny opis produktu, tabelę parametrów i informacje kontaktowe, podczas gdy początkowa odpowiedź HTML zawiera jedynie podstawową strukturę dokumentu. Google dysponuje mechanizmami renderowania JavaScriptu, ale nie wszystkie systemy automatycznie pobierające strony działają w taki sam sposób. Dlatego istotne informacje warto udostępniać również w kodzie HTML przesyłanym przez serwer, na przykład poprzez renderowanie po stronie serwera lub wcześniejsze generowanie dokumentów. Pozwala to ograniczyć zależność dostępności treści od możliwości konkretnego robota. Szczególnie ważne jest, aby podstawowe informacje o firmie, opisy usług, produkty, nagłówki i linki wewnętrzne nie były ukryte wyłącznie za mechanizmami wymagającymi dodatkowego przetwarzania przez przeglądarkę.
Problem 4: Nieprawidłowe odpowiedzi HTTP i przekierowania. Dostępność strony zależy nie tylko od jej wyglądu, lecz także od sposobu komunikowania się serwera z klientem. Poprawnie działająca publiczna podstrona zazwyczaj powinna zwracać odpowiedź HTTP 200, natomiast błędy 403, 404 lub 5xx mogą uniemożliwiać pobranie jej zawartości. Problemem bywają również rozbudowane łańcuchy przekierowań, niespójna konfiguracja protokołu HTTPS oraz błędy certyfikatów bezpieczeństwa. Takie nieprawidłowości mogą powodować, że określony robot nie dotrze do właściwego dokumentu, mimo że zwykła przeglądarka poradzi sobie z częścią przeszkód. Problem 5: Niewłaściwe dyrektywy indeksowania i niespójne metadane. Znaczniki meta robots, nagłówki X-Robots-Tag czy błędnie wskazane adresy kanoniczne mogą utrudniać interpretowanie przeznaczenia podstrony. Należy jednak pamiętać, że sposób honorowania tych dyrektyw zależy od konkretnego systemu, dlatego nie można automatycznie zakładać identycznego zachowania wszystkich asystentów AI. Prawidłowa diagnostyka powinna obejmować zarówno komunikację HTTP, jak i informacje znajdujące się w kodzie dokumentu.
Problem 6: Niekompletne lub niespójne dane strukturalne. Dane schema.org pozwalają opisywać wybrane elementy witryny w sposób uporządkowany, ułatwiający maszynową interpretację informacji. W przypadku strony firmowej mogą dotyczyć organizacji, danych kontaktowych, adresu lub profilu działalności. Sklep internetowy może dodatkowo wykorzystywać oznaczenia produktów, ofert, cen i dostępności. Częstym problemem jest jednak nie tylko całkowity brak odpowiedniego kodu, ale również jego nieprawidłowa składnia albo sprzeczność z informacjami wyświetlanymi użytkownikowi. Jeżeli cena w danych strukturalnych różni się od aktualnej ceny produktu, a wskazany numer telefonu nie odpowiada danym kontaktowym firmy, dokument staje się mniej jednoznaczny. Warto więc regularnie weryfikować zgodność oznaczeń z rzeczywistą zawartością strony. Nie należy jednak traktować schema.org jako gwarancji wykorzystania witryny przez ChatGPT lub inne modele. Dane strukturalne są elementem porządkującym informacje, a nie uniwersalnym mechanizmem zapewniającym cytowanie.
Problem 7: Słaba struktura treści i brak jednoznacznych informacji o ofercie. Nawet jeśli robot poprawnie pobiera stronę, jej zawartość może być trudna do zinterpretowania z powodu niewłaściwej organizacji tekstu. Ogólne hasła reklamowe, nieczytelne nagłówki, brak opisów produktów oraz powtarzające się akapity nie pomagają w zrozumieniu rzeczywistego zakresu działalności firmy. Duże znaczenie ma przejrzysta hierarchia informacji, w której tytuł dokumentu określa główny temat, nagłówki rozwijają poszczególne zagadnienia, a akapity dostarczają konkretnych odpowiedzi. W przypadku usług warto jasno przedstawiać specjalizację, lokalizację, sposób realizacji i warunki współpracy. Sklepy internetowe powinny udostępniać szczegółowe parametry produktów, ich zastosowania, ceny i zasady zakupu. Pomocne jest również logiczne linkowanie wewnętrzne, dzięki któremu można łatwiej odnajdywać powiązane informacje. Dobrze opracowana struktura treści służy przede wszystkim użytkownikom, ale jednocześnie wspiera systemy automatyczne analizujące zawartość witryny.
Skuteczna optymalizacja strony pod kątem systemów AI powinna rozpoczynać się od uporządkowania kwestii technicznych, które można obiektywnie zweryfikować. W pierwszej kolejności warto sprawdzić dostępność najważniejszych podstron, poprawność odpowiedzi serwera, konfigurację robots.txt oraz zachowanie zabezpieczeń antybotowych. Następnie należy przeanalizować, czy główna treść oferty jest dostępna bez wykonywania JavaScriptu i czy witryna posiada logiczną strukturę nagłówków oraz linkowania. Istotnym etapem jest również kontrola danych strukturalnych, metadanych i zgodności informacji publikowanych w różnych częściach serwisu. Nie każda firma musi udostępniać wszystkim robotom identyczny zakres zasobów. Decyzje dotyczące botów wykorzystywanych do trenowania modeli mogą wynikać z polityki ochrony treści i strategii właściciela witryny. Najważniejsze jest więc świadome konfigurowanie dostępu w zależności od celu biznesowego, a nie automatyczne odblokowywanie wszystkich mechanizmów pobierających informacje.
Drugim filarem powinna być jakość publikowanych materiałów. Rozwój wyszukiwania opartego na sztucznej inteligencji nie oznacza, że firmy powinny zastępować wartościowe opisy ofert tekstami tworzonymi wyłącznie pod algorytmy. Wręcz przeciwnie, szczególnego znaczenia nabierają informacje konkretne, aktualne, jednoznaczne i przydatne dla odbiorców. Warto rozbudowywać treści odpowiadające na rzeczywiste pytania klientów, uzupełniać dokumentację produktów, wyjaśniać zasady korzystania z usług i konsekwentnie prezentować doświadczenie przedsiębiorstwa. Takie działania wspierają tradycyjne SEO, a jednocześnie tworzą lepsze warunki do interpretowania oferty przez automatyczne systemy wyszukujące informacje. Należy również prowadzić regularne kontrole techniczne, ponieważ zmiana konfiguracji serwera, instalacja nowych zabezpieczeń czy przebudowa witryny mogą ponownie wprowadzić ograniczenia dostępu. Systematyczna diagnostyka pozwala wcześniej wykrywać problemy i eliminować je, zanim zaczną negatywnie wpływać na funkcjonowanie internetowych kanałów dotarcia do klientów.
Widoczność firmy w świecie sztucznej inteligencji zaczyna się od prawidłowo przygotowanej strony internetowej. Nawet wartościowa oferta może mieć ograniczone szanse na wykorzystanie jako źródło informacji, jeśli odpowiednie roboty nie są w stanie pobrać jej zawartości lub napotykają błędy techniczne. Problemy z robots.txt, zabezpieczeniami serwera, JavaScriptem, odpowiedziami HTTP, metadanymi, danymi strukturalnymi i organizacją treści warto więc traktować jako ważne elementy nowoczesnego audytu SEO. Ich wykrycie i usunięcie nie gwarantuje automatycznego pojawienia się w odpowiedziach ChatGPT, Gemini czy Perplexity, ale pomaga stworzyć odpowiednie techniczne podstawy do rozwijania obecności marki w nowych kanałach wyszukiwania. Dla przedsiębiorców oznacza to przede wszystkim możliwość świadomego przygotowania strony na zmieniające się zachowania użytkowników i rosnącą rolę sztucznej inteligencji w procesie podejmowania decyzji zakupowych.